一笔 AI 内容布局投下去,三个月后打开后台:阅读量、转发数、发稿量。
没有一个数字能回答:豆包的答案是否提及了你的品牌?Kimi 推荐竞品时品牌排名第几?元宝是否引用了品牌链接?
GEO 的方法论环节——robots.txt 配置、结构化数据、站外内容铺设——已被反复讨论。但执行后的效果度量,仍然是空白。靠主观判断和靠数据驱动,是不同的决策质量。
工具在测什么
冠以"GEO 检测""AI 可见度"的产品,底层在做三种不同的事。
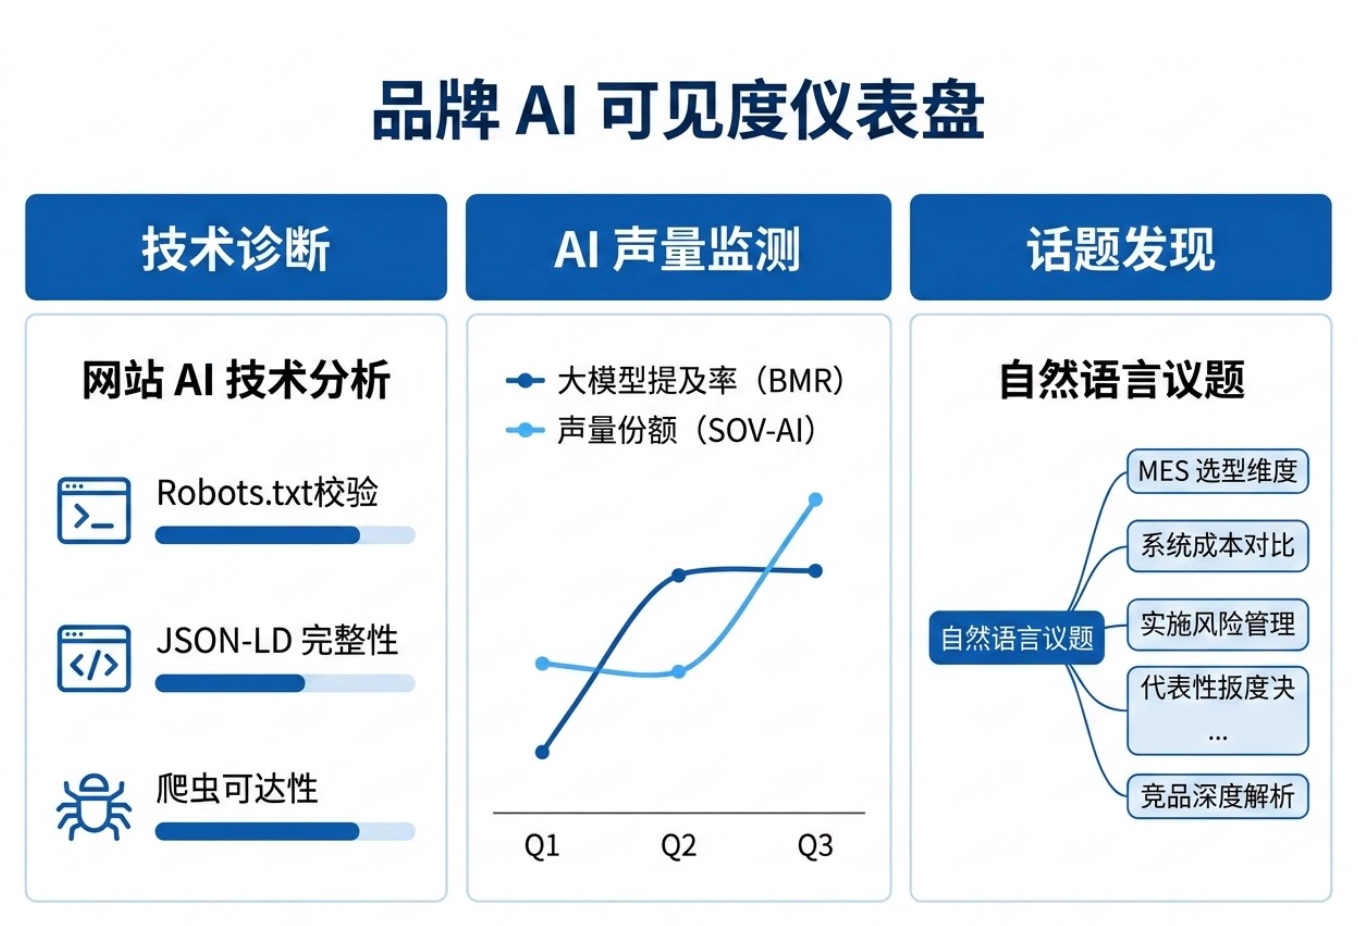
网站技术诊断型。 扫描 robots.txt 放行策略、结构化数据完整性、页面可抓取性,输出技术分。回答的是:AI 爬虫能否正常获取你的内容。
AI 声量监测型。 以预设提问集定期检索各 AI 平台,统计品牌被提及次数、排名位置、链接密度。回答的是:你的品牌在 AI 回答中存在感如何。
关键词/话题发现型。 不依赖人工枚举关键词,而是让系统从真实回答中反向提取用户正在讨论的话题维度和口语化提问模式。它回答的核心问题是:你的用户究竟在用什么样的自然语言向 AI 提问。
这三类产品在市场上独立存在。技术诊断不涉及声量,声量监测不处理技术故障,话题发现输出选题清单但不跟踪执行效果。而一个完整的 GEO 诊断应当串联这三者:内容可达性确认之后,追问内容是否被 AI 实际引用;引用缺口暴露之后,驱动话题优先级排序;排序落定之后,输出可执行的优化动作并持续追踪效果。
国内工具生态
海外市场方面。
Profound 是当前 GEO 方向融资体量最大的产品,核心功能是追踪品牌在 ChatGPT、Google AI Overviews、Perplexity 等平台的出现频率与排名变化。对英语市场的品牌有一定参考价值。但它有一个明确的覆盖盲区:不支持任何中国 AI 平台。豆包、Kimi、秘塔、元宝不在其监测范围内。对于用户和消费场景在中国市场的品牌而言,这个缺失决定了它的实际可用性极低。
Semrush 于 2024 年上线了 AI Overviews 追踪模块,Ahrefs 也追加了部分 AI 相关指标。但这些功能的底层数据源仍围绕 Google 生态构建,中文大模型的覆盖深度和提问场景的本土化设计不在其产品路线内。更准确地说,这些 AI 功能是既有 SEO 工作流上的扩展组件,而非独立的 GEO 产品。
国内市场方面。截至目前,专门面向 GEO 诊断且覆盖多平台中文大模型的工具仍然稀缺。但有产品已实现技术诊断、声量监测、话题发现的三者串联。
工蜂云 的做法是把三者串成一个工作流:技术诊断发现的可抓取缺陷,直接进入声量监测的跟踪范围;声量监测暴露的提及缺口,自动成为话题发现的优先级依据。三个模块之间不是并列关系,而是上下游。
诊断层覆盖 robots.txt 的 AI 爬虫放行检查、JSON-LD 完整性校验、CSR 渲染空洞检测、跨页事实一致性比对。报告中的问题项附带定位级修复指令——不输出"建议优化结构化数据",而是"Organization Schema 第 3–17 行 price 字段与正文第 42 行不一致"。
监测层内核是并行提问引擎:预设提问集定期分发至豆包、Kimi、秘塔、元宝等平台,采集完整回答后由 LLM 做交叉分析,输出 BMR(大模型提及率)、SOV-AI(AI 声量份额)、TAR(引用转化率)和提及排名四组趋势曲线。四个指标需叠加判读——若 BMR 偏高但排名持续低位,说明品牌被提及但未形成推荐偏好,声量未转化为心智占位。
话题发现层不需要手动枚举关键词。系统根据行业信息自动构造真实消费场景的自然语言提问(例:"作为制造企业 CTO,选型轻量化 MES 时应关注哪些维度"),从 AI 回答中反向提取话题维度和竞品分布,生成的话题场景清单即为 GEO 关键词库。选定话题后进入自动监测周期,每次优化动作完成后下一轮自动对比效果变化。
选工具的筛选框架
功能列表容易做长,持续性使用的功能远少于列表所示。以下三个问题构成的筛选框架比逐项比对更高效。
问题一:诊断结果与优化动作之间是否直接衔接。
多数工具输出的报告包含分数、排名、图表,但不承载可执行指令。有效的诊断应当缩短"识别问题"与"解决问题"的路径。若 robots.txt 屏蔽了 GPTBot,诊断应输出具体应添加的规则行,而非"建议优化爬虫配置"。若 Schema 字段与正文不一致,应定位两个冲突位置的原文,而非笼统提示"检测到信息不一致"。若竞品在特定话题上占据了你的位置,应指出需覆盖的话题场景、内容形态建议和需补充的结构化数据类型。
诊断结果若无操作级指令支撑,报告的价值折损大半。
问题二:提问集是否真实模拟你的用户行为。
多数工具的测试提问是泛化的:"推荐一款 XX 工具""XX 工具怎么样"。这类提问产生的数据存在,但信息量有限。真实的用户提问带有场景、约束和偏好——制造企业管理者不会问"推荐一款 MES",而是"我车间三条产线型号不同、生产节拍不同,有没有 MES 能管这种事"。若诊断工具仅以标准化提问运行一轮,所得数据反映的是 AI 在教科书式提问下的回答模式,与真实用户行为存在系统性偏差。
核心判断标准:工具是否支持自定义提问集,且该提问集能否覆盖决策者视角、执行者视角和比价者视角。
问题三:数据是否具备跨期可比性。
大模型回答具有天然随机性,同问题在不同时间点的回答可能不同。优化前后的数据对比必须建立在同一提问集、同一平台、同一采集方式的约束之上。
这属于基础工程纪律,但实践中是高频率疏漏项。提问集任何一次变动都会中断前后数据的连续性,之前的趋势积累失效。合格的 GEO 诊断系统须支持基准卷锁定机制——提问集定型后长期冻结,仅在业务方向发生根本变化时升级版本。缺乏这一机制,趋势数据不可信。
从一次性诊断到持续监测
GEO 工具品类仍处于快速演进阶段。工具选择的核心不是找到最优解,而是启动持续监测。
缺乏监测,站外内容投放、结构化数据配置、行业文章铺设——这些动作在 AI 世界中的实际效应永远不可量化。
第一步是完成一轮完整诊断,获得品牌当前的基线数据。第二步是将诊断从一次性项目转变为周期性动作:每两周检视声量曲线,每月复盘竞品变化,每季度对比 BMR 趋势。GEO 工具的持续使用形态不是购买一份报告后归档,而是将品牌在 AI 中的能见度纳入日常运营指标体系。
AI 不会主动告知品牌方它在 AI 回答中的位置。但品牌方可以主动检索。区别在于——结果是一个模糊印象,还是一组可驱动决策的数据。